Выбор варианта рискового портфеля
Известны математические модели теории эффективного портфеля, основанные на работах Марковица [1,2]. К сожалению, сложность этих моделей ограничивает их практическое применение. Однако главная причина заключается даже не в сложности, а в типичном противоречии между точностью вычислительного алгоритма и возможностью получения достоверных исходных данных для его реализации. Другими словами, теоретически обоснованные и точные расчеты часто выполняются на основе заведомо недостоверных данных, поскольку в реальной жизни получить необходимую информацию в полном объеме практически невозможно. Понятно, если на вход компьютера мы подаем мусор, то независимо от количества производимых с ним манипуляций на выходе мы его и получаем. Прежде всего, это касается проблемы статистических зависимостей между различными активами. Разумеется, получение оценок линейных коэффициентов корреляции по известным временным рядам доходности является тривиальной задачей. Однако учет этих оценок вследствие их неизбежной условности представляет лишь теоретический интерес, неоправданно усложняя задачу. С точки зрения автора, при разработке управленческих решений надо в принципе отказаться от идеи поиска глобального оптимума, а использовать приближенные методы, соответствующие возможной точности исходной информации.
В данной статье предлагается алгоритм принятия решения о выборе рациональной структуры набора инвестиций по стандартным критериям доходности и риска. При этом рассматривается только несистематический (диверсифицируемый) риск, управляемый менеджером портфеля. Полученные результаты проверены на имитационной модели при различных начальных условиях и используются в деловой игре “Риск-инвест” для студентов экономических и строительных специальностей.
Вероятностная модель
Эффект диверсификации, обеспечивающий снижение риска, в определенной мере аналогичен эффекту резервирования (дублирования) в теории надежности систем [3]. При этом параллельно с основным элементом работает один или несколько резервных (рис.1).
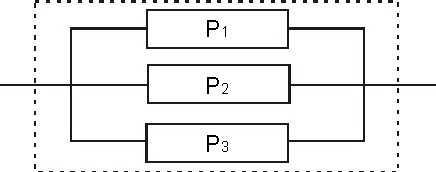
Рисунок 1. Параллельная система
Надежность системы в целом определяется по уравнению:
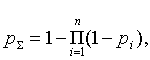 (1)
где рS - надежность системы;
рi – надежность i-го элемента;
n – число элементов.
Под надежностью в этом случае понимают вероятность того, что случайное время работы элемента или системы будет больше или равно заданному. Из формулы (1) видно, что при любой надежности элементов можно создать систему требуемой надежности. На этом принципе основан синтез надежных систем из ненадежных компонент. Если все составляющие элементы имеют одинаковую надежность рi=р, то число необходимых элементов для обеспечения заданной надежности системы рS можно найти из формулы, которая следует из (1):
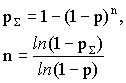 . (2)
Таким образом, добавление каждого следующего элемента снижает риск для системы в целом. Например, мы имеем несколько независимых и равноценных по эффективности проектов, но по разным объектам инвестирования и шансы каждого из них – пятьдесят на пятьдесят. Тогда вероятность успеха при реализации лишь одного проекта, как видно из формулы (1), остается такой же, то есть – 0.5; в случае двух – 0.75; трех – 0.875; четырех – 0.937 и т.д. Оценка риска определяется как дополнение до единицы. Число параллельно работающих инвестиций можно назвать кратностью диверсификации. Темп роста эффективности диверсификации J с увеличением ее кратности n определяется по формуле, которая следует из (2):
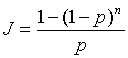
Видно, что увеличение кратности оказывает наибольшее влияние при малых значениях n. Например, реализация одновременно двух проектов снижает риск на 50%, четырех - на 87%, пяти – на 94%. Предельное значение при дальнейшем увеличении кратности равно 100%.
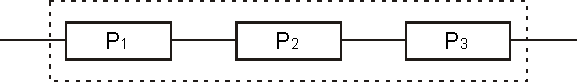
Если элементы взаимодействуют последовательно (рис.2), что также имеет место в анализе эффективности инвестиций, то надежность системы определяется как произведение соответствующих показателей для структурных составляющих (рис.2).
Рисунок 2. Последовательная система
 (3)
Отсюда следует, что для обеспечения требуемой эффективности последовательной системы необходимы более высокие показатели каждого звена, причем с увеличением числа звеньев общая надежность уменьшается.
В обеих системах (параллельная и последовательная) под надежностью понимается вероятность безотказной работы, то есть вероятность того, что случайное время работы элемента или системы будет равно или больше заданного. Конечно, при формировании и использовании инвестиционного портфеля никаких отказов не происходит. Но, имея предполагаемый набор активов и статистические характеристики каждого из них, можно установить границы доходности, вероятность превышения которых соответствует вероятности успеха, а вероятность непревышения – риску потерь:
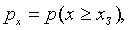 (4)
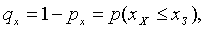 (5)
где рx – вероятность получения доходности равной или больше заданной хЗ;
qx – вероятность неполучения заданной доходности хЗ (риск).
В качестве исходной информации используется средняя доходность ( ), среднее квадратическое отклонение (s
х) и коэффициент вариации (Vx), полученные обработкой временных рядов за несколько предыдущих лет по каждому виду активов:
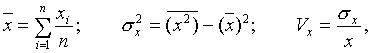 (6)
где xi – значение доходности в году с номером i, %;
n – число лет, по которым имеется информация;
 - средний квадрат случайной величины х;
 - дисперсия х;
 - квадрат средней доходности.
Из формулы для дисперсии следует, что средний квадрат случайной величины одним числом оценивает среднее значение случайной величины и степень рассеивания ее относительно среднего:
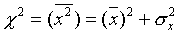 . (7)
На основании этого свойства c 2 широко используют для оценки точности систем управления. На практике удобнее использовать арифметическое значение квадратного корня из среднего квадрата, имеющее размерность случайной величины.
Если данных о динамике доходности нет или их недостаточно, то исходные статистические характеристики можно получить на основе индивидуальных или групповых экспертных оценок:
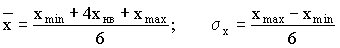 , (8)
где xmin, xнв, xmax – пессимистическая, наиболее вероятная и оптимистическая оценка предполагаемой годовой нормы прибыли по данному активу соответственно.
Однако для решения поставленной задачи необходимо знать законы распределения доходности по каждому виду активов, которые обычно неизвестны. Поэтому вводим вполне реальные допущения относительно вида этих законов.
Если известно, что возможные значения случайной величины доходности заключены в определенных пределах и нет оснований предсказать наиболее вероятную оценку, то используется закон равномерной плотности, для которого вероятность получения доходности рх, не меньше заданной хз, определяется по формуле:
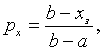 (9)
где a = xmin;
b = xmax.
Среднее значение и дисперсия для этого закона соответственно равны:
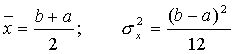 . (10)
Если известно, что возможны отклонения доходности относительно наиболее вероятного значения в обе стороны и коэффициент вероятности Vx£
0.33, то принимаем нормальный закон распределения, который зависит от двух параметров и s
х. Вероятность px получения дохода, больше или равного заданной величины х3:
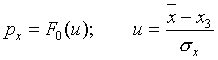 , (11)
где F0(u) – табулированная функция.
Если коэффициент вариации доходности актива по исходной информации Vx>0.33, принимаем распределение Вейбулла-Гнеденко. Выбор этого закона обусловлен, в частности, теми же причинами, что и популярность степенной функции в задачах моделирования, прогнозирования и оптимизации: малое число коэффициентов и гибкая структура. Вероятность рХ получения доходности, большей или равной заданной хз определяется по формуле:
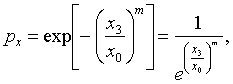 (12)
где m и x0 – параметры формы и масштаба соответственно.
Параметры m и x0 определяют по таблицам в зависимости от значения коэффициента вариации, полученного в результате обработки исходной информации. Если таблиц нет, а коэффициент вариации находится в пределах 0.33¸ 0.72, то для приближенной оценки можно использовать следующие соотношения:
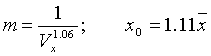 . (13)
Данный закон в зависимости от параметра формы пригоден для экспоненциального распределения доходности (m=1), распределения Релея (m=2) и близкого к нормальному (m³ 3), то есть является достаточно универсальным. Кроме того, в общем случае, плотность вероятностей имеет правостороннюю асимметрию (скошено влево), что соответствует экономической сущности явления: вероятность больших доходов значительно меньше, чем сравнительно малых.
При формировании портфеля инвестиций с вероятностной точки зрения происходит композиция распределений по отдельным активам, поэтому основной задачей является нахождение и изучение поведения закона распределения суммы независимых слагаемых. Если число активов портфеля достаточно велико, то в соответствии с центральной предельной теоремой закон распределения доходности портфеля в целом является нормальным независимо от распределения составляющих элементов и их доли в портфеле. Например, композиция двух одинаковых равномерных распределений дает треугольное, а трех – близкое к нормальному [4].
Для наглядности рассмотрим простой пример, взятый из монографии Е.М. Четыркина [5]. Портфель должен состоять из двух видов ценных бумаг, статистические характеристики которых даны в табл.1. Коэффициент корреляции между активами равен нулю. Параметры m и x0 найдены по таблицам распределения Вейбулла-Гнеденко.
Таблица 1.
Статистические характеристики ценных бумаг
|
Вид бумаги |
Средняя доходность
|
Стандартное отклонение s х |
Коэффициент вариации Vx |
Параметр формы m |
Параметр масштаба х0 |
|
1 |
2 |
0.8 |
0.40 |
2.70 |
2.25 |
|
2 |
3 |
1.1 |
0.37 |
2.94 |
3.36 |

Задаемся рядом значений требуемой доходности портфеля в диапазоне возможных значений, например: 1; 1.5; 2.0; 2.5; 3.0; 3.5. Далее по формуле (12) определяем соответствующие вероятности их получения для обеих бумаг pх1 и pх2. Результаты сведены в табл.2.; здесь же даны вероятности противоположных событий qx1 и qx2, то есть риск неполучения заданного дохода.
Таблица 2.
Результаты расчетов
|
хЗ |
pх1 |
pх2 |
qx1 |
qx2 |
|
1.0 |
0.89 |
0.97 |
0.11 |
0.03 |
|
1.5 |
0.71 |
0.91 |
0.29 |
0.09 |
|
2.0 |
0.48 |
0.80 |
0.52 |
0.20 |
|
2.5 |
0.26 |
0.66 |
0.74 |
0.34 |
|
3.0 |
0.11 |
0.49 |
0.89 |
0.51 |
|
3.5 |
0.04 |
0.32 |
0.96 |
0.68 |
Вероятности pх1 и pх2 означают, что, например, при заданной доходности хз=2, эту доходность могут обеспечить акции первого вида в 48 случаях из 100, а акции второго вида в 80 случаях из 100. Отсюда следует, что при заданной доходности удельные веса каждого вида актива должны быть пропорциональны этим значениям, то есть их надо пронормировать в долях единицы:
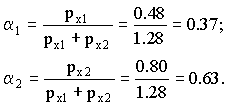
Используя полученные значения, можно определить статистические характеристики данного портфеля.
Средний доход:
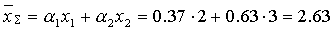
Стандартное отклонение:
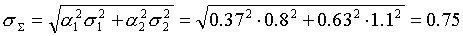
Коэффициент вариации:
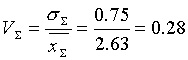
Результаты расчета статистических характеристик для шести вариантов портфелей даны в табл.3.
Таблица 3.
Результаты расчета статистических характеристик
|
xз |
a 1 |
a 2 |
|
s S |
VS |
рS |
qS |
|
1.0 |
0.48 |
0.52 |
2.52 |
0.69 |
0.27 |
0.99 |
0.01 |
|
1.5 |
0.44 |
0.56 |
2.56 |
0.71 |
0.28 |
0.93 |
0.07 |
|
2.0 |
0.37 |
0.63 |
2.63 |
0.75 |
0.28 |
0.80 |
0.20 |
|
2.5 |
0.28 |
0.72 |
2.72 |
0.82 |
0.30 |
0.60 |
0.40 |
|
3.0 |
0.18 |
0.82 |
2.82 |
0.91 |
0.32 |
0.43 |
0.57 |
|
3.5 |
0.12 |
0.88 |
2.88 |
0.97 |
0.34 |
0.26 |
0.74 |

Видно, что для любого варианта коэффициент вариации доходности портфеля VS меньше минимального из его структурных составляющих Vx1 и Vx2 (табл.1.).
Задача оценки весовых коэффициентов легко решается с помощью табулированной функции нормального распределения, поскольку коэффициент вариации доходности активов не намного превышает допустимые границы. При этом риск определяется по формуле:
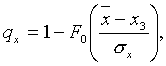 причем F0(-u)=1-F0(u) (14),
где F0(u) – табличная функция нормального распределения.
Вероятность противоположного события, то есть получения дохода равного или большего х3, определяется из уравнения:
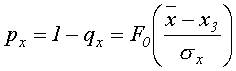 . (15)
Например, если требуемая доходность х3=2.5, то вероятность получения этой величины дохода составляет:
- для первого актива:
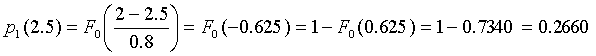 ;
- для второго актива:
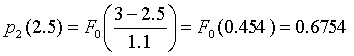 .
Расчет весовых коэффициентов выполняется на основе условия нормировки  :
0.2660+0.6754=0.9414.
Отсюда следует: 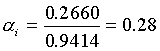 ;
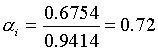
Таким образом, мы получили те же результаты, что и при использовании другого типа распределения доходности и те же, что в примере Е.М. Четыркина, но не заданные, а рассчитанные по предлагаемой методике. На основе таблиц функции нормального закона рассчитаны показатели риска рS
и qS
для портфеля в целом по расчетным характеристикам  и
 . Оценки этих показателей можно получить в виде средней арифметической рS
а и средней геометрической рS
г с весами, равными доле каждого актива в наборе инвестиций:
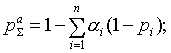 (16)
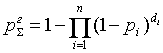 , (17)
где рi – вероятность превышения заданной доходности по i-му активу;
 – доля i-го актива в портфеле.
Поскольку взвешенное среднее арифметическое является нижней границей для среднего арифметического с теми же весами:
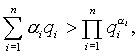 (18)
то оценка вероятности по формуле для рS а всегда несколько меньше рS г за исключением случая, когда все qi равны между собой и тогда рS а = рS г. Следует, кстати, отметить, что это важное свойство является основой геометрического программирования в теории оптимизации.
Полученные результаты (табл.3) в принципе позволяют лицу, принимающему решение, выбрать приемлемый вариант с учетом увеличения риска при росте доходности портфеля. В качестве количественного критерия для выбора оптимального варианта можно использовать любой из известных критериев принятия решения в условиях риска: ожидаемого значения, наиболее вероятного (модального) значения, предельного уровня, ожидаемого значения с учетом его вариации [6].
Критерий ожидаемого значения в данном случае формулируется в виде:
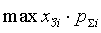 , (19)
где xзi и рS i – заданная доходность и ее вероятность для портфеля в целом.
Критерий наиболее вероятного значения предполагает выбор по правилу:
 , (20)
где xm – модальное значение доходности.
Для распределения Вейбулла-Гнеденко эта величина определяется по формуле:
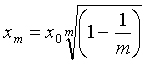 , (21)
где х0 и m – параметры масштаба и формы соответственно.
Критерий предельного уровня в данном случае является квантилью соответствующего распределения. Для закона Вейбулла-Гнеденко при заданной вероятности g предельный уровень хg определяется по формуле:
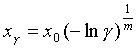 . (22)
Обычно g принимают равной 0.8, 0.9, 0.95. Для нормального распредельного распределения:
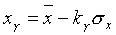 , (23)
где k – табличный коэффициент в зависимости от принятого уровня вероятности g (k80=0.842; k90=1.282; k95=1.645).
Последний критерий “ожидаемое значение с учетом его вариации” в данном случае практически полностью совпадает с предыдущим и тоже формулируется в виде:
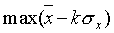 . (24)
Разница заключается лишь в том, что лицо, принимающее решение, может выбрать значение k намного больше единицы в зависимости от его “несклонности” к риску, например, k=2 и более. Используя последний критерий при k=2 получим, что наиболее приемлемым вариантом является второй, хотя значения критерия для первых трех вариантов мало отличаются друг от друга (1.14, 1.15, 1.13), а последующие три варианта имеют значения критерия соответственно: 1.08, 1.00, 0.94.
Таким образом, для расчета характеристик доходности портфеля необходима информация о законах распределения доходности составляющих его активов. Как правило, более или менее достоверно определены лишь числовые характеристики, а законы распределения доходности остаются неизвестными. При этом возникает ситуация неопределенности, в которой возможны две альтернативы. В первом случае экспертным путем принимаются априорные распределения для каждого актива, как предлагается в данной статье. Во втором случае статистические характеристики портфеля определяются на основе принципа получения гарантированного результата, то есть рассчитываются гарантированные оценки доходности портфеля при наихудших возможных законах распределения доходности составляющих активов. Для расчета гарантированной оценки вероятности получения заданной доходности, когда вид закона распределения рх произволен, а известны лишь средние значения и дисперсия доходности s
х2, можно использовать формулу, полученную Ю.Б. Гермейером [7]:
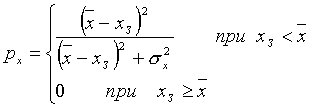 (25)
Поскольку эта формула справедлива при возможных наихудших условиях, то есть для случая крайнего пессимизма, ее можно использовать для исключения заведомо неприемлемых вариантов портфеля. К ним относятся все альтернативы, для которых заданная доходность больше средней доходности портфеля, то есть два последних варианта, так как для них гарантированная вероятность равна нулю.
Имитационная модель
Идея метода имитационного моделирования чрезвычайно проста и в принципе может быть реализована без применения ПК, а с помощью современного калькулятора, имеющего, как правило, датчик случайных чисел и встроенные программы для сложных функций и статистических вычислений. Дело в том, что большинство практических задач, даже если их удается представить в виде аналитических зависимостей, в качестве аргументов результирующего показателя содержат случайные величины или случайные функции, которые обычно характеризуются средними значениями и флуктуациями относительно средних. При этом можно задать вероятные нижние и верхние границы факторных аргументов и для них рассчитать значения результирующего показателя. Однако сразу возникает вопрос, в каком сочетании выбирать эти границы для различных действующих факторов. Если взять все оптимистические или, наоборот, пессимистические границы, то такие расчеты не представляют практического интереса, так как в реальной жизни очень редко встречаются ситуации, чтобы все было абсолютно хорошо или абсолютно плохо. Можно выполнить расчет по наиболее вероятным значениям аргументов, но тогда мы просто уходим от необходимости учета допусков, то есть возможных флуктуаций показателей в будущем.
Имитационное моделирование позволяет решить эту проблему и при наличии аналитических зависимостей и при их отсутствии. При этом производится моделирование случайного явления с помощью заранее обусловленной процедуры, дающей случайный результат [8]. Каждый раз мы получаем одну возможную реализацию случайного явления. Повторяя эту процедуру многократно, мы получим множество реализаций и соответственно множество возможных значений результирующего показателя. Другими словами, формируется выборка, которую можно обработать обычными методами теории статистики с целью получения статистических характеристик анализируемого показателя (гистограмма, кумулята, среднее, дисперсия и т.д.).
Для применения метода необходимо:
- знать вероятностные характеристики факторных аргументов;
- знать правило вычисления результирующего признака при любых фиксированных значениях аргументов.
Одной из первых задач по применению метода Монте-Карло является задача определения среднего времени безотказной работы изделия по известным характеристикам безотказной работы каждого составляющего элемента.
Мы приводим этот пример по той причине, что он позволяет с предельной простотой показать практическое применение имитационного моделирования. Кроме того, несмотря на абсолютные внешние различия с обсуждаемым вопросом, методика решения обеих задач почти одинакова.
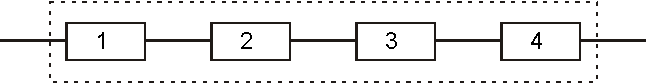
Если считать, что ресурс каждого элемента фиксированная величина, то определить ресурс изделия не представляет труда, например, для изделия, схема которого показана на рис.3., в котором выход из строя одного элемента влечет за собой выход из строя всего изделия, ресурс равен минимальному из ресурсов составляющих элементов:
t=min/t1, t2, t3, t4/. (26)
Рисунок 3. Структурная схема простой системы
Для изделия, схема которого показана на рис. 4., где один элемент дублирован:
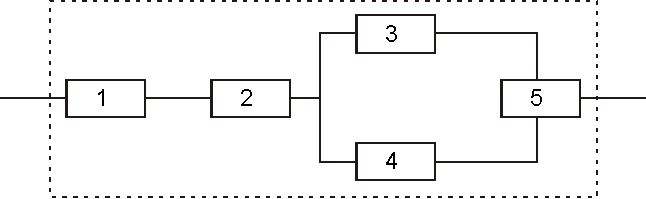
t=min [t1, t2, max(t3, t4), t5]. (27)
Рисунок 4. Структурная схема сложной системы
Приведенная формула (27) отражает тот факт, что если, например, элемент 3 выйдет из строя, то изделие будет нормально работать на элементе с номером 4.
В действительности ресурс любого элемента представляет собой случайную величину. Если мы говорим, что срок службы электрической лампочки составляет 1000 ч, то это лишь среднее значение. Все знают, что одна лампочка перегорает быстрее, а другая, в точности такая же, горит дольше.
Если известны параметры функций распределения ресурсов составляющих элементов, то для каждого из них разыгрывается возможное значение (реализация) ресурса ti. Затем по формулам (26) или (27) определяется одна соответствующая реализация ресурса изделия. Множество полученных реализаций обрабатывается по общим правилам статистики для получения характеристик распределения ресурса изделия.
Таким образом, в качестве исходной информации необходимо знать вероятностные характеристики элементов рассматриваемой системы и правило вычисления интересующих нас величин как функции от параметров элементов. Тогда случайность параметров учитывается в процессе моделирования. Как видно из этого примера, с помощью метода можно еще на стадии проектирования оценить качество любых изделий, состоящих из стандартных элементов с известными вероятностными характеристиками, а также оценивать изменение качества при замене одних элементов другими, то есть существует практически полная аналогия с задачей анализа портфеля инвестиций.
Имитационное моделирование по существу представляет собой статистический эксперимент, поэтому результаты достигают стационарных значений только после его многократного повторения. Необходимое число реализаций (прогонов моделей) определяется по известным формулам для оптимального объема выборки. Следует отметить, что результаты не изменятся, если вместо непрерывного процесса моделирования на ПК с заданным числом реализаций использовать сумму реализаций, полученную в результате индивидуальной работы студентов группы численностью 20-25 человек с использованием калькулятора, снабженного датчиком случайных чисел (ДСЧ).
Датчик случайных чисел выдает случайные числа, равномерно распределенные в интервале от 0 до 1. Случайные величины с любыми законами и параметрами распределения легко получить на основе этих чисел.
В случае равномерного распределения случайной величины в интервале от a до b случайные числа xi получают путем линейного преобразования:
xi = a + e i× (b - a), (28)
где e i- случайное число ДСЧ.
Например, если надо найти три случайных числа, равномерно распределенных в интервале от 10 до 15, то используя подряд числа ДСЧ получим:
x1=10+0.858× (15-10)=14.29;
x2=10+0.465× (15-10)=12.32;
x3=10+0.167× (15-10)=10.83.
Если предполагается, что распределение случайной величины нормальное, то применяется одна из следующих формул:
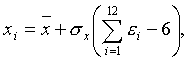 (29)
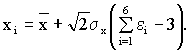 (30)
При значении коэффициента вариации Vx>0.33 используется распределение Вейбулла-Гнеденко. Случайная величина определяется по формуле:
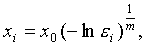 (31)
где x0 и m – параметры масштаба и формы соответственно.
Параметры распределения x0 и m получают либо по таблицам в зависимости от коэффициента вариации, либо методом максимального правдоподобия, либо с использованием масштабно-координатной сетки, на которой функция распределения с помощью двойного логарифмирования преобразуется в линейную. Для приближенной оценки параметров x0 и m можно использовать формулы (13).
Для получения статистических характеристик портфеля методом имитационного моделирования предполагается, что известны годовая норма прибыли по каждому активу (xi), коэффициент вариации (Vi) и удельные веса каждого актива в общей стоимости инвестиций (a i) при допущении об отсутствии взаимной корреляции, хотя на модели это учесть несложно.
Исходные данные, которые использовались для проверки предложенной методики, представлены в табл.4.
Таблица 4.
Исходная информация для апробации предложенной методики
|
Вид актива |
Годовая норма прибыли |
Коэффи-циент вариации |
Весовой коэффи- циент |
Параметры распределения |
|
|
m |
x0 |
||||
|
1 |
10 |
0.3 |
0.5 |
4.0 |
11 |
|
2 |
15 |
0.5 |
0.3 |
2.0 |
17 |
|
3 |
20 |
0.7 |
0.2 |
1.4 |
22 |
Случайные реализации доходности по каждому активу получаются из условий:
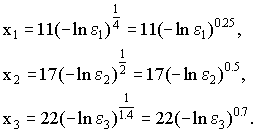
По каждой реализации фиксируются минимальное, максимальное значения доходности, размах, среднеарифметическая и среднегеометрическая доходность. Через каждые 100 реализаций определяются соответствующие средние по выборке и среднеквадратическое отклонение. Затем прогоны продолжают пока процесс изменения этих величин не стабилизируется. Полученный массив статистической информации позволяют построить гистограммы выходных показателей и получить все необходимые характеристики портфеля.
Литература
- Ковалев В.В. Введение в финансовый менеджмент. – М.: Финансы и статистика, 1999.
- Дж. Брайен, С. Шристава. Финансовый анализ и торговля ценными бумагами. – М.: Дело ЛТД, 1995.
- Дружинин Г.В. Методы оценки и прогнозирования качества. – М.: Радио и связь, 1982.
- Смирнов Н.В., Дунин-Барковский И.В. Курс теории вероятностей и математической статистики для технических приложений. - M.: Наука, 1969.
- Четыркин Е.М. Финансовый анализ производственных инвестиций. - М.: Дело, 1998.
- Таха Х. Введение в исследование операций. - М.: Мир, 1985.
- Росин М.Ф. Статистическая динамика и теория эффективности систем управления. – M.: Машиностроение, 1970.
- Бусленко Н.П. Метод статистического моделирования - М.: Статистика, 1970.
[an error occurred while processing this directive]
