Как при помощи математики сэкономить деньги при проведении статистических опросов
Михеев Андрей Геннадьевич системный аналитик Консалтинговой группы «РУНА», кандидат физико-математических наук
Несмотря на то что раздел статистики, относящийся к вычислению характеристик различных выборок, давно и очень хорошо всем известен, оказалось, что применения «студенческих» знаний математики (второй-третий курс обычного технического вуза) достаточно, чтобы существенно повысить экономическую эффективность некоторых видов статистических исследований (опросов), проводимых коммерческими компаниями.
Большинство компаний, занимающихся опросами, получив от заказчика задание на исследование, рассчитывая размер выборки (количество людей, которых надо опросить), полностью игнорирует полученное распределение ответов. Многие компании просто не проводят исследования с выборками менее 1 000 человек, считая их недостаточно надежными.
Однако в некоторых случаях опросы относительно небольшого количества респондентов могут иметь весьма высокую точность.
Рассмотрим типичные подходы к оценке точности статистического опроса.
Задача. Имеется целевая аудитория из N человек. Из них доля ν (то есть ν N человек) при ответе на вопрос анкеты назвала бы пункт «А», если бы опросили всю целевую аудиторию. Остальные респонденты дали бы другие ответы. Пусть реально из целевой аудитории было опрошено только n человек. Из них доля η (то есть η n человек) при ответе на вопрос анкеты назвала пункт «А». Эта величина была взята в качестве приближенного значения ν. Как можно оценить погрешность произведенного исследования?
Наиболее простой подход состоит в следующем:
Для оценки вероятности получить то или иное значение величины ц используется биномиальное распределение (распределение вероятностей числа появлений некоторого события при повторных независимых испытаниях). Пусть при каждом испытании вероятность появления некоторого события равна р, (0 ≤ p ≤ 1), k — число появлений этого события при n независимых испытаниях. Тогда частота  - есть случайная величина, принимающая значения
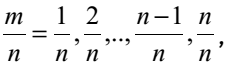 с вероятностями
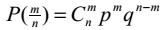 где q = 1 — p, a
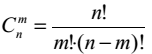 биномиальные коэффициенты. Математическое ожидание и дисперсия величины, имеющей биноминальное распределение, известны и равны соответственно
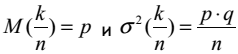 .
В нашем случае p = ν, q = 1 — ν. Далее к случайной величине ,имеющей биноминальное распределение, применяется неравенство Чебышева. Это неравенство дает оценку вероятности того, что случайная величина примет значение, далекое от своего среднего.
Формулировка неравенства Чебышева: Пусть ν — математическое ожидание и σ2 — дисперсия случайной величины η. Тогда
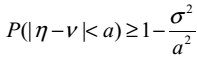 (1)
где a > 0.
Дисперсию биноминального распределения можно оценить сверху:
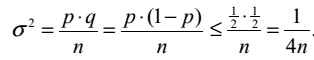 (2)
Определим так называемый доверительный интервал — интервал возможных значений величины η, в который конкретное значение этой величины должно попасть с очень высокой вероятностью. Эта вероятность называется границей вероятности.
Зададим границу вероятности 0.99 (т. е. вероятность того, что оценка выполняется — 0.99). Теперь, пользуясь неравенством Чебышева, найдем такую величину выборки, чтобы для этой величины погрешность статистического определения v не превышала 5 процентов (т. е. a = 0.05). Подставляя значение a и оценку для σ2 в неравенство Чебышева, получим оценку для величины выборки n:
n ≥ 10 000.
То есть в рамках данного подхода, для того чтобы с вероятностью 0.99 получить погрешность исследования не более 5 процентов, надо опросить не менее 10 000 человек.
Эта оценка является слишком грубой и ее можно улучшить.
Известно, что неравенство Чебышева дает сильно завышенную оценку. Рассмотрим способы ее улучшения. Известно, что в силу теоремы Лапласа при больших n биноминальное распределение стремится к нормальному. Для нормального распределения выполняется следующее равенство
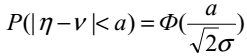 (3)
где Ф(х) — функция Лапласа:
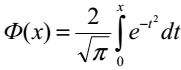
Взяв табличное значение функции Лапласа для x = 0.99 и подставив оценку (2) для дисперсии, получим, что для того, чтобы с вероятностью 0.99 получить погрешность исследования не более 5 процентов, достаточно опросить не 10 000 человек, а всего лишь 664.
Полученную оценку во многих случаях можно еще улучшить.
Дело в том, что в формуле (2) мы оценили дисперсию сверху. Эта оценка выполняется, когда величинаvблизка к 1/2.Если же она сильно отличается от 1/2, то дисперсия будет заметно ниже. Например, пусть ν = 4, тогда
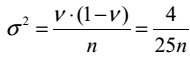
Здесь существует трудность — во время проведения исследования мы не знаем величину ν — мы как раз и пытаемся ее определить, однако при помощи оценки для ν мы можем оценить сверху значение σ2 (Вентцель Е.С. Теория вероятностей).
Применяя эту оценку для случая η = 0.8 получим, что нам достаточно опросить 558 человек для того, чтобы с вероятностью 0.99 получить погрешность исследования не более 5 процентов.
В некоторых случаях можно улучшить точность оценки еще сильнее.
В формуле 1 мы предполагали, что N >> n. В некоторых случаях при проведении опросов это условие не выполняется. Например, исследуется мнение директоров предприятий определенной отрасли. Пусть в России существует только 1 000 таких предприятий. Здесь существенным является то, что выборка является выборкой без повторений — т. е. второй раз одно и то же предприятие в рамках одного исследования не опрашивается.
В этом случае величина имеет гипергеометрическое распределение:
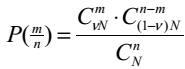 (4)
Матожидание случайной величины η, имеющей гипергеометрическое распределение (4) равно и, дисперсия:
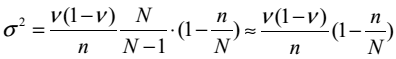 (5)
Для гипергеометрического распределения можно доказать аналог теоремы Лапласа: при увеличении n и N, но при фиксированном отношении r = n/N гипергеометрическое распределение стремится к нормальному. То есть для этого распределения выполняется оценка (3), однако дисперсия опрелеляется формулой (5).
Проведя необходимые вычисления, получим, что в случае п = 0.8 и N = 1 000, для того чтобы с вероятностью 0.99 получить погрешность исследования не более 5 процентов, надо опросить 358 респондентов.
В некоторых случаях можно еще уменьшить размер выборки.
Но и это еще не все. Даже в случае больших N существуют пути получения надежных результатов при помощи серий небольших выборок.
Как правило, заказчика исследования интересует не абсолютная погрешность получившихся статистических величин, а относительная:
Например: Если доля респондентов, назвавших пункт «А» в первом вопросе анкеты составляет 3%, а статистическая погрешность составляет 12%, то погрешность исследования слишком большая. Однако, если доля респондентов будет 80%, а погрешность такая же, то большинство заказчиков устроит такая точность, если, конечно, речь не идет о рейтингах СМИ. То есть можно будет гарантировать с высокой точностью, что доля респондентов всей целевой аудитории, которые бы назвали пункт «А», если бы всех опросили, с высокой точностью не будет ниже 68 процентов. Для практического применения зачастую важно не абсолютное значение, а относительная важность различных пунктов, по которым проводятся исследования. И если явно выявлено, что один из пунктов важнее других, то этого заказчику достаточно для использования результатов исследования. И это является важным, так как исследование — не самоцель. Оно проводится для того, чтобы применять полученные данные.
Стоимость опросов прямо пропорциональна количеству опрашиваемых (надо напечатать анкеты, нанять интервьюеров, обработать результаты). Причем для увеличения точности опроса в 2 раза надо увеличить величину выборки в 4 раза (см. формулы (2), (3), (5), т. е. величина выборки растет квадратично при увеличении точности, что приводит к большим затратам при проведении исследований.
Поэтому при проведении исследований можно выбрать другую стратегию увеличения точности исследований:
Проводить последовательные опросы относительно небольшого количества респондентов, так формулируя вопросы анкет, чтобы частота некоторого ответа была бы существенно выше всех остальных частот ответов на этот вопрос. Например, вместо вопроса, «Какими важными качествами должен обладать...?», допускающего много ответов, помещать в анкету вопрос «Каким самым важным качеством должен обладать.?», допускающий только один ответ и т. д.
При таком подходе мы с большей вероятностью будем получать на выходе вместо диаграммы распределения ответов, показанной на рисунке 1, диаграмму распределения ответов, показанную на рисунке 2.
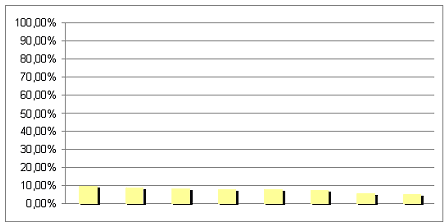
Рисунок 1.
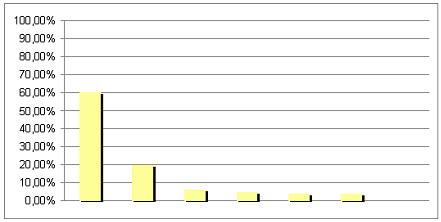
Рисунок 2.
Если опрос не выявил ответов с высокими частотами, то он признается неудачным и его результаты не учитываются, если опрос оказался удачным, то на основании его результатов формулируются вопросы анкеты для нового — «уточняющего» опроса.
Если воспользоваться аналогией с поиском корня функции методом деления отрезка пополам, то можно надеяться, что при увеличении точности в данном случае количество опрошенных респондентов будет расти не квадратично, а логарифмически, что принципиально снизитзатраты на исследования.
Конечно, данный подход будет эффективен, только если уметь «правильно» формулировать вопросы. Это — некоторое искусство, для этого существуют различные методики, существуют также эксперты, которые умеют это делать. То есть при помощи данного подхода один квалифицированный эксперт может заменить целую армию интервьюеров и существенно снизить затраты на исследование.
Примером такой методики может служить технология маркетинговых исследований, разработанная Хаббардом. В частности, в этой методике впервые было введено понятие «кнопки». Под «кнопкой» в данном случае подразумевается ответ, который дали большинство респондентов (то есть самый популярный ответ). И если выстраивать весь маркетинг на «кнопках», как предлагает данный автор, то при проведении маркетинговых исследований нет смысла в опрашивании большого числа респондентов. Ведь для того, чтобы найти «кнопку», вполне достаточно выборки в 100—200 человек. И это действительно может изменить подход к количественным исследованиям за исключением исследований рейтингов, то есть тех исследований, где необходимо получить максимально точное значение для каждого пункта, а не только выявить самый популярный пункт.
В целом необходимо отметить, что проведение количественных исследований (опросов) посредством серии малых выборок (особенно при поиске «кнопок») может послужить фактором существенного снижения временных и денежных затрат, и, как следствие, повышения эффективности, казалось бы, всем давно известных методик.
[an error occurred while processing this directive]
